Was ist Workflow-Orchestrierung?
Workflow-Orchestrierung ist die Koordinationsschicht oberhalb einzelner automatisierter Tasks. Sie steuert deren Reihenfolge, zeitliche Ausführung und Abhängigkeiten, damit ein Prozess über alle beteiligten Systeme hinweg korrekt abgeschlossen wird.
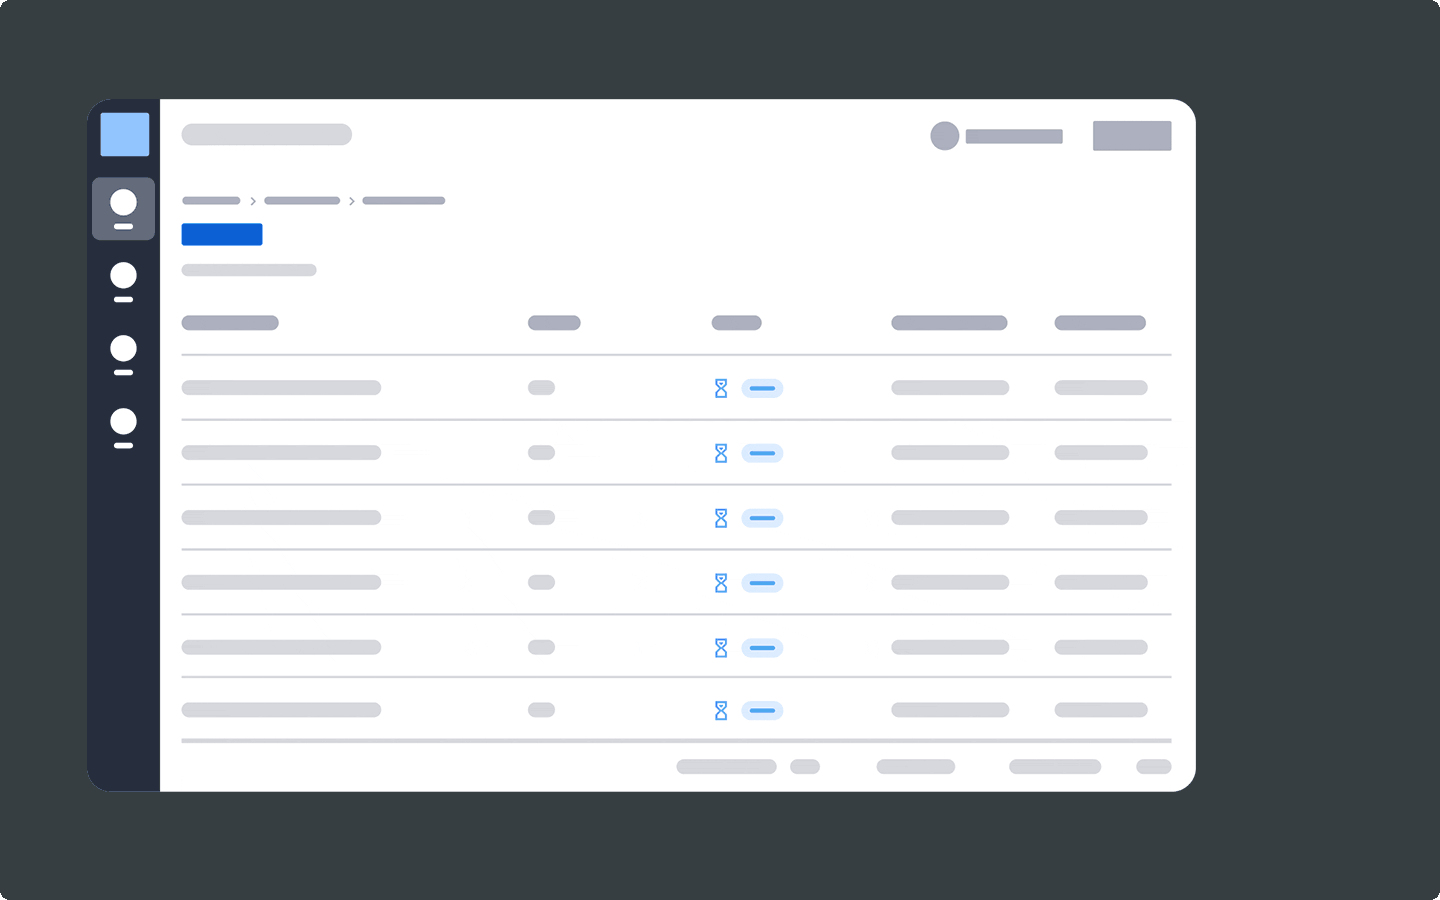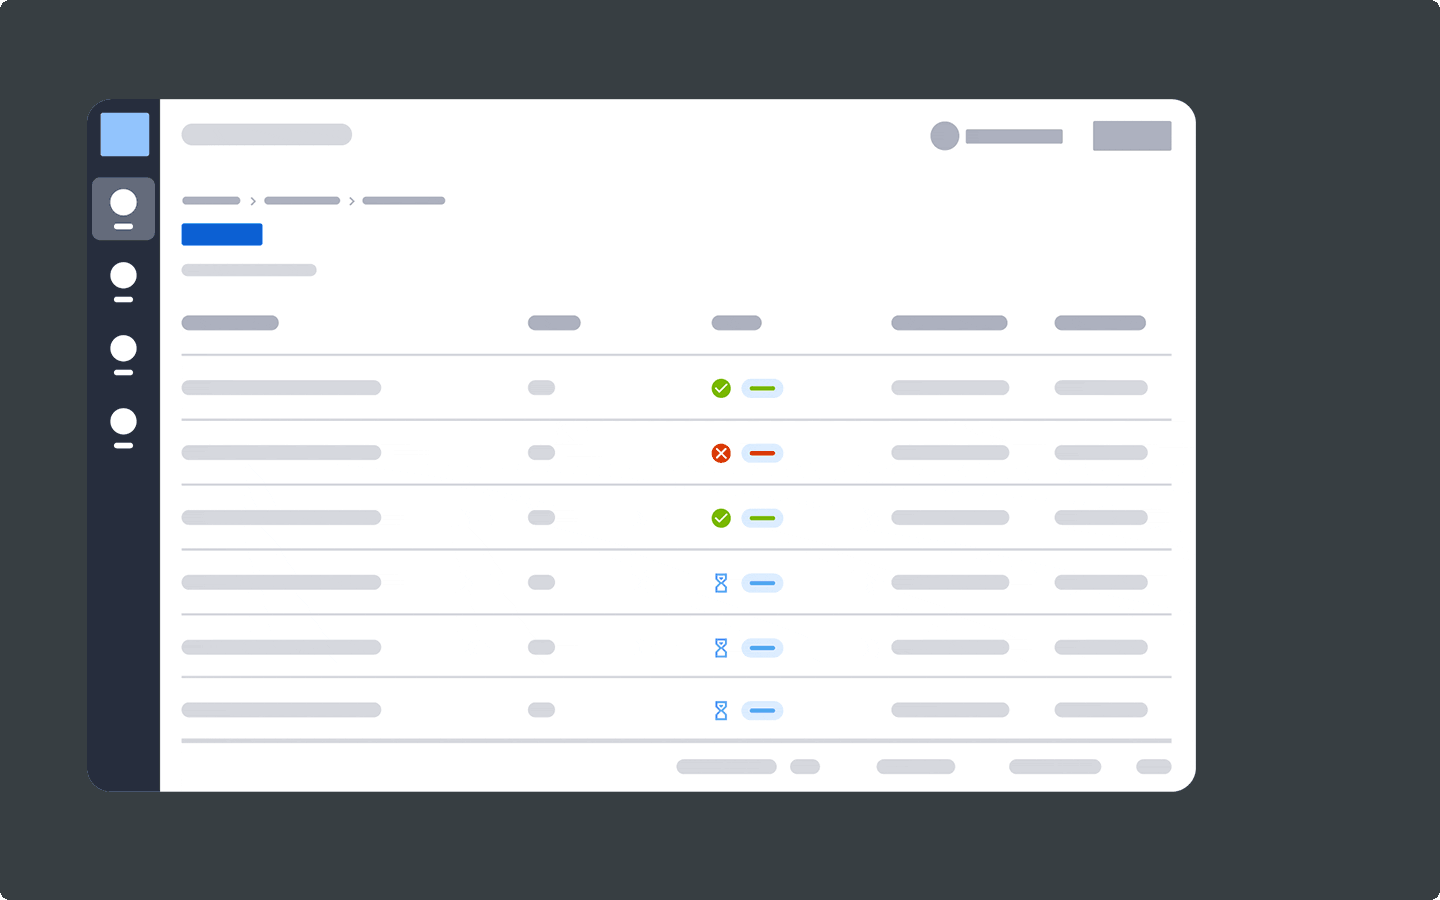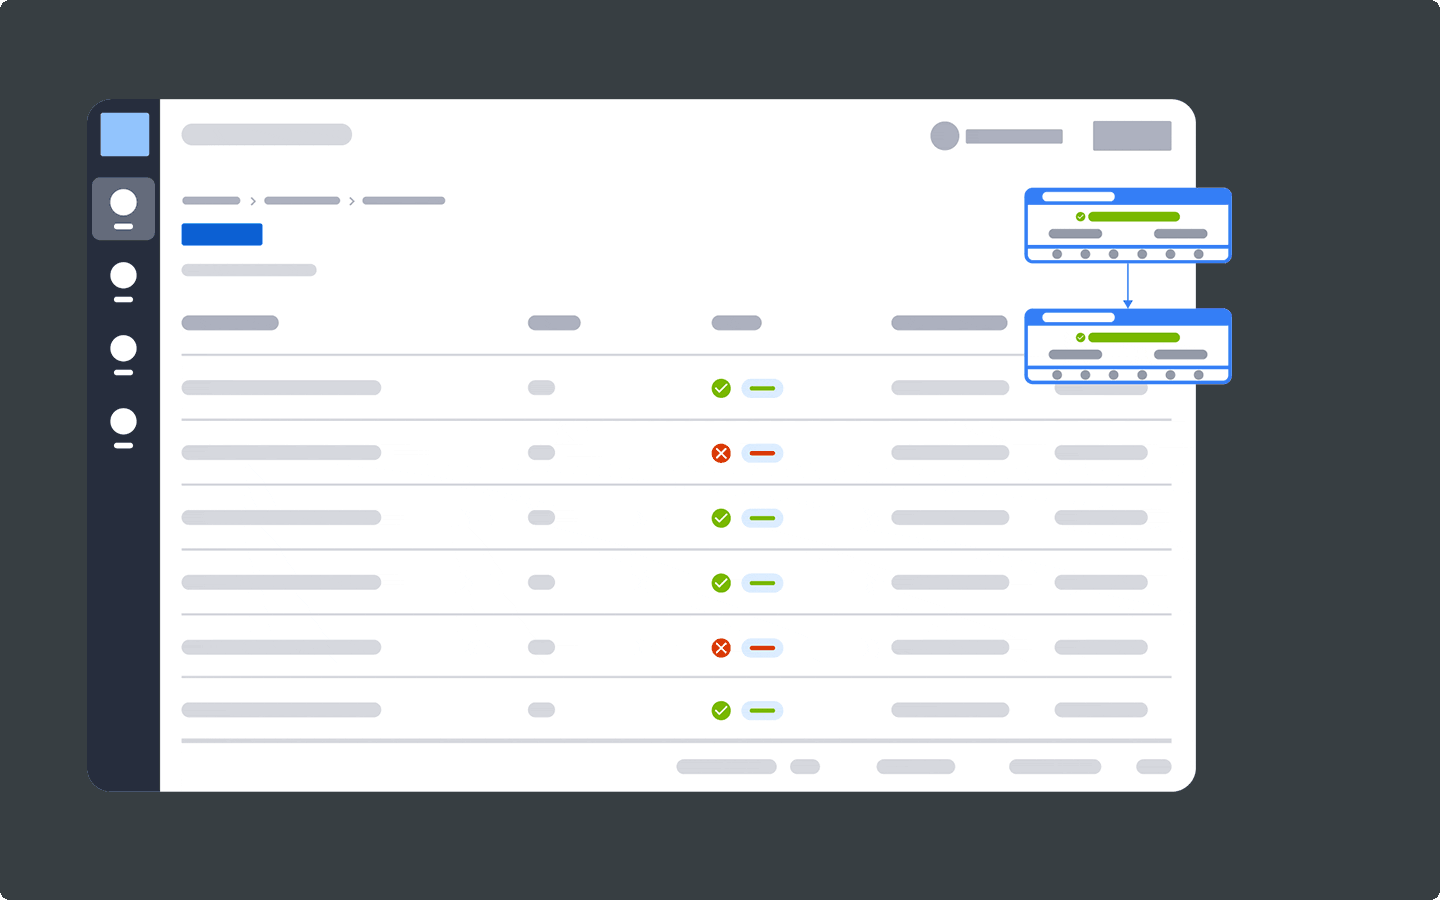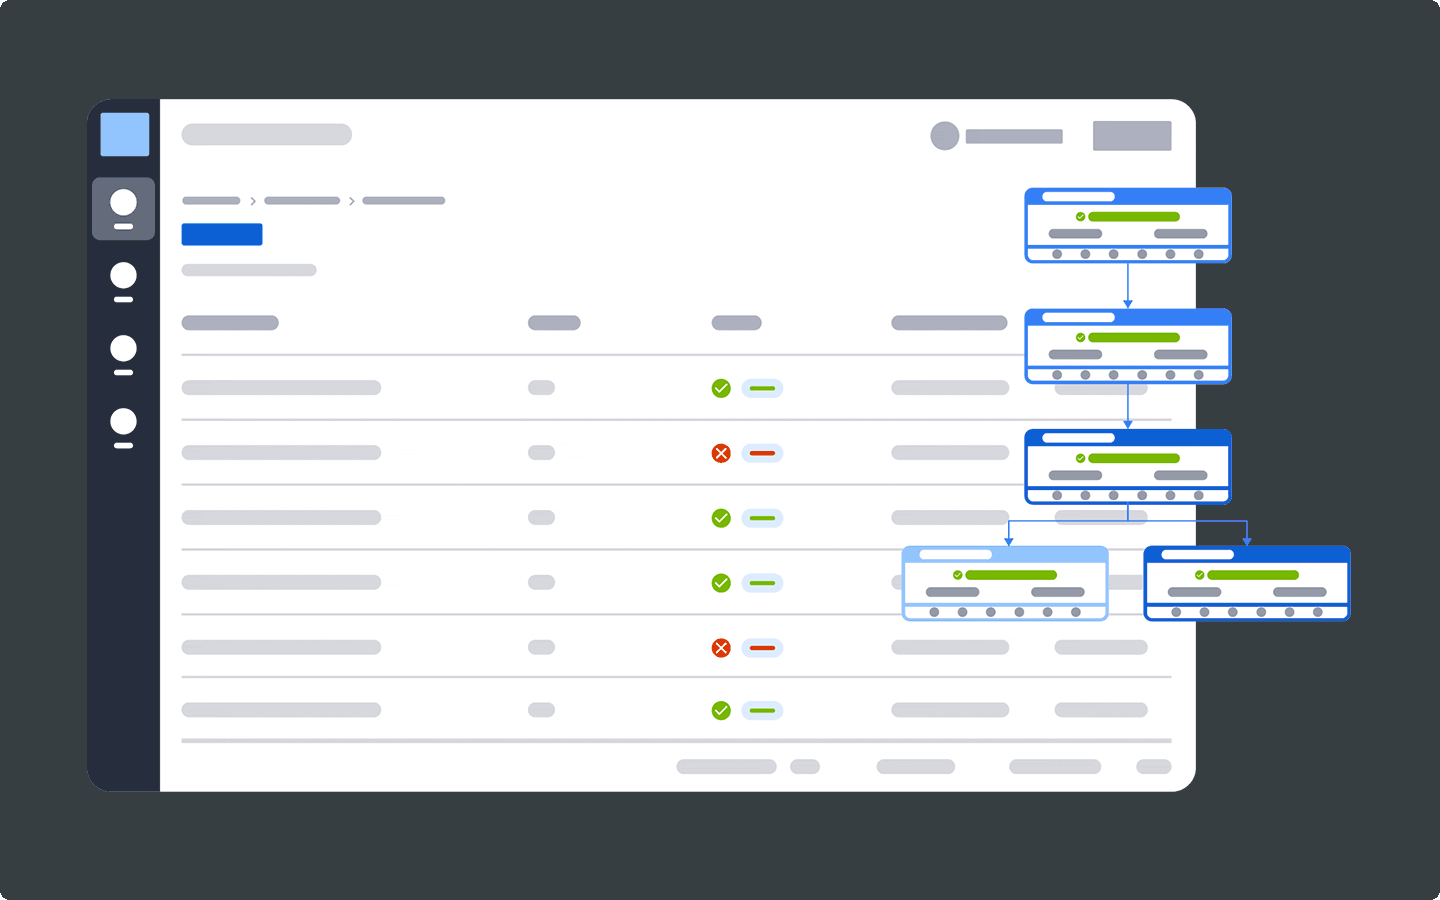
Statt sich auf die Automatisierung eines einzelnen Tasks zu konzentrieren, steuert die Orchestrierung das Zusammenspiel bereits automatisierter Tasks. Dazu gehören Trigger, die Ausführungsreihenfolge, Fehlerbehandlung und der Datenfluss zwischen den einzelnen Tasks.
Während Task-Automatisierung manuelle Arbeit innerhalb eines einzelnen Prozessschritts reduziert, sorgt Orchestrierung dafür, dass dieser Schritt in der richtigen Reihenfolge, zum richtigen Zeitpunkt und abgestimmt auf alle vor- und nachgelagerten Schritte ausgeführt wird.
Eine ausführlichere Einführung in die Grundlagen der Workflow-Orchestrierung finden Sie in unserem Leitfaden.
So funktioniert Workflow-Orchestrierung Schritt für Schritt
Orchestrierungsplattformen unterscheiden sich hinsichtlich Benutzeroberfläche und Skalierbarkeit. Der grundlegende Ausführungsprozess folgt jedoch einem einheitlichen Muster. Sehen wir uns an, was zwischen dem Auslösen eines Triggers und dem erfolgreichen Abschluss eines Workflows passiert.
Schritt 1: Trigger-Erkennung und Jobdefinition
Jeder Workflow beginnt mit einem Trigger, zum Beispiel:
einem geplanten Zeitpunkt
dem Eingang einer Datei in einem Verzeichnis
der Änderung eines Datenbank-Flags
einem API-Aufruf
dem Abschluss eines vorgelagerten Jobs
Moderne Orchestrierungsplattformen unterstützen all diese Trigger parallel, anstatt sämtliche Abläufe an starre Zeitpläne zu binden. Das ist entscheidend, da reale IT-Prozesse nur selten ausschließlich nach festen Zeitplänen ablaufen.
Bei der Definition wird jeder Job deklarativ beschrieben: was er ausführt, von welchen anderen Jobs oder Bedingungen er abhängt und welche Ressourcen er benötigt. Diese Informationen werden nicht fest in einem Skript hinterlegt. Dadurch lassen sich Workflows leichter zwischen verschiedenen Umgebungen übertragen und besser auditieren.
Schritt 2: Abhängigkeiten auflösen und Ausführungsreihenfolge festlegen
Bevor die Ausführung beginnt, erstellt die Orchestrierungs-Engine einen Abhängigkeitsgraphen. Dieser zeigt, welche Jobs abgeschlossen sein müssen, bevor andere starten können, welche Jobs parallel ausgeführt werden können und welche sich gegenseitig ausschließen, weil sie dieselbe Ressource benötigen.
Ein Scheduler kann Jobs zum vorgesehenen Zeitpunkt starten. Ein Orchestrator weiß darüber hinaus, dass Job C erst ausgeführt werden darf, wenn sowohl Job A als auch Job B erfolgreich abgeschlossen wurden. Schlägt Job B fehl, müssen Job C und alle nachgelagerten Jobs pausiert oder auf einen alternativen Pfad umgeleitet werden, anstatt einfach wie geplant zu starten.
Schritt 3: Verteilte Ausführung über die gesamte IT-Umgebung
Sobald die Ausführungsreihenfolge feststeht, startet die Plattform jeden Job dort, wo er ausgeführt werden muss: auf einem On-Premises-Server, in einem Container, in einem Cloud-Service oder innerhalb eines ERP-Systems. Die Ansteuerung erfolgt über Agents, agentenlose APIs oder eine Kombination aus beidem.
Auf Enterprise-Ebene muss diese Ausführungsschicht den Status potenziell Tausender gleichzeitig laufender Jobs über Cloud-, On-Premises- und Mainframe-Systeme hinweg zuverlässig verwalten. Dabei muss jederzeit nachvollziehbar bleiben, welcher Job zu welchem Geschäftsprozess gehört.
Schritt 4: Echtzeit-Monitoring und Observability
Während Workflows ausgeführt werden, erfasst die Plattform Metriken, Logs und Traces, die zunehmend über OpenTelemetry standardisiert werden. Operations-Teams erhalten dadurch eine zentrale Echtzeitansicht über den Zustand ihrer Workflows, anstatt für jedes System ein separates Dashboard überwachen zu müssen.
Hier lassen sich auch SLA-Risiken frühzeitig erkennen. Eine auf den jeweiligen Workflow-Kontext abgestimmte Observability kann beispielsweise erkennen, dass ein Job voraussichtlich eine Deadline verfehlen wird. So bleibt noch Zeit einzugreifen, bevor daraus konkrete Auswirkungen auf den Geschäftsbetrieb entstehen.
Schritt 5: Automatisierte Wiederherstellung und Fehlerbehebung
Tritt ein Fehler auf, wenden Orchestrierungsplattformen vordefinierte Wiederherstellungslogiken an. Dazu gehören beispielsweise automatische Wiederholungsversuche, Failover-Pfade und Benachrichtigungen, die sich an den Auswirkungen auf den Geschäftsbetrieb orientieren. So muss nicht erst ein Mitarbeiter den Fehler bemerken und den betroffenen Job manuell neu starten.
Fortschrittlichere Plattformen ergänzen diese Funktionen um KI-gestützte Diagnosen. Dabei werden aktuelle Fehler mit historischen Mustern korreliert, um Operations-Teams gezielt auf mögliche Ursachen hinzuweisen, anstatt die Ursachenanalyse jedes Mal bei null beginnen zu lassen.
Dieser geschlossene Kreislauf von der Erkennung bis zur Fehlerbehebung unterscheidet echte Orchestrierung von einer Sammlung unabhängig voneinander automatisierter Tasks.
Workflow-Automatisierung vs. Orchestrierung: Wo viele Teams den Unterschied übersehen
Teams, die Orchestrierung lediglich als „mehr Automatisierung“ verstehen, haben am Ende häufig Dutzende gut automatisierte Tasks, deren Reihenfolge, Überwachung und Wiederherstellung trotzdem manuell gesteuert werden müssen. Genau diese Koordinationslücke soll Orchestrierung eigentlich schließen.
So unterscheiden sich die beiden Konzepte:
Workflow-Automatisierung | Workflow-Orchestrierung | |
|---|---|---|
Umfang | Ein einzelner Task oder Prozess | Mehrere Tasks, Systeme und deren Abhängigkeiten |
Goal | Manuelle Arbeit innerhalb eines einzelnen Schritts reduzieren | Reihenfolge, zeitliche Ausführung und Übergaben zwischen einzelnen Schritten koordinieren |
Fehlerbehandlung | Ein Task schlägt fehl und in der Regel wird ein Mitarbeiter benachrichtigt | Ein Fehler löst automatisierte Wiederherstellungsmaßnahmen, eine Umleitung oder einen Rollback innerhalb des Workflows aus |
Typische Arbeitseinheit | Ein Skript, ein Bot oder ein geplanter Job | Ein systemübergreifender End-to-End-Geschäftsprozess |
Teams, die lediglich einzelne Tasks automatisieren, stoßen häufig irgendwann an eine Grenze: Mit jedem neuen System kommt eine weitere manuelle Übergabe hinzu, eine weitere potenzielle Fehlerquelle und ein weiteres Dashboard, für dessen kontinuierliche Überwachung im Arbeitsalltag die Zeit fehlt.
Tipp
Cloud-Orchestrierung und SAP-Orchestrierung sind zwei Bereiche, in denen diese Grenzen besonders schnell sichtbar werden, da hier regelmäßig ein Dutzend oder mehr voneinander abhängige Systeme zusammenspielen.
Typische Anwendungsfälle für Workflow-Orchestrierung
Orchestrierung kommt überall dort zum Einsatz, wo ein Geschäftsprozess davon abhängt, dass mehrere Systeme ihre Aufgaben in der richtigen Reihenfolge ausführen. Drei der häufigsten Anwendungsszenarien in Unternehmen sind:
Orchestrierung von SAP- und ERP-Prozessen
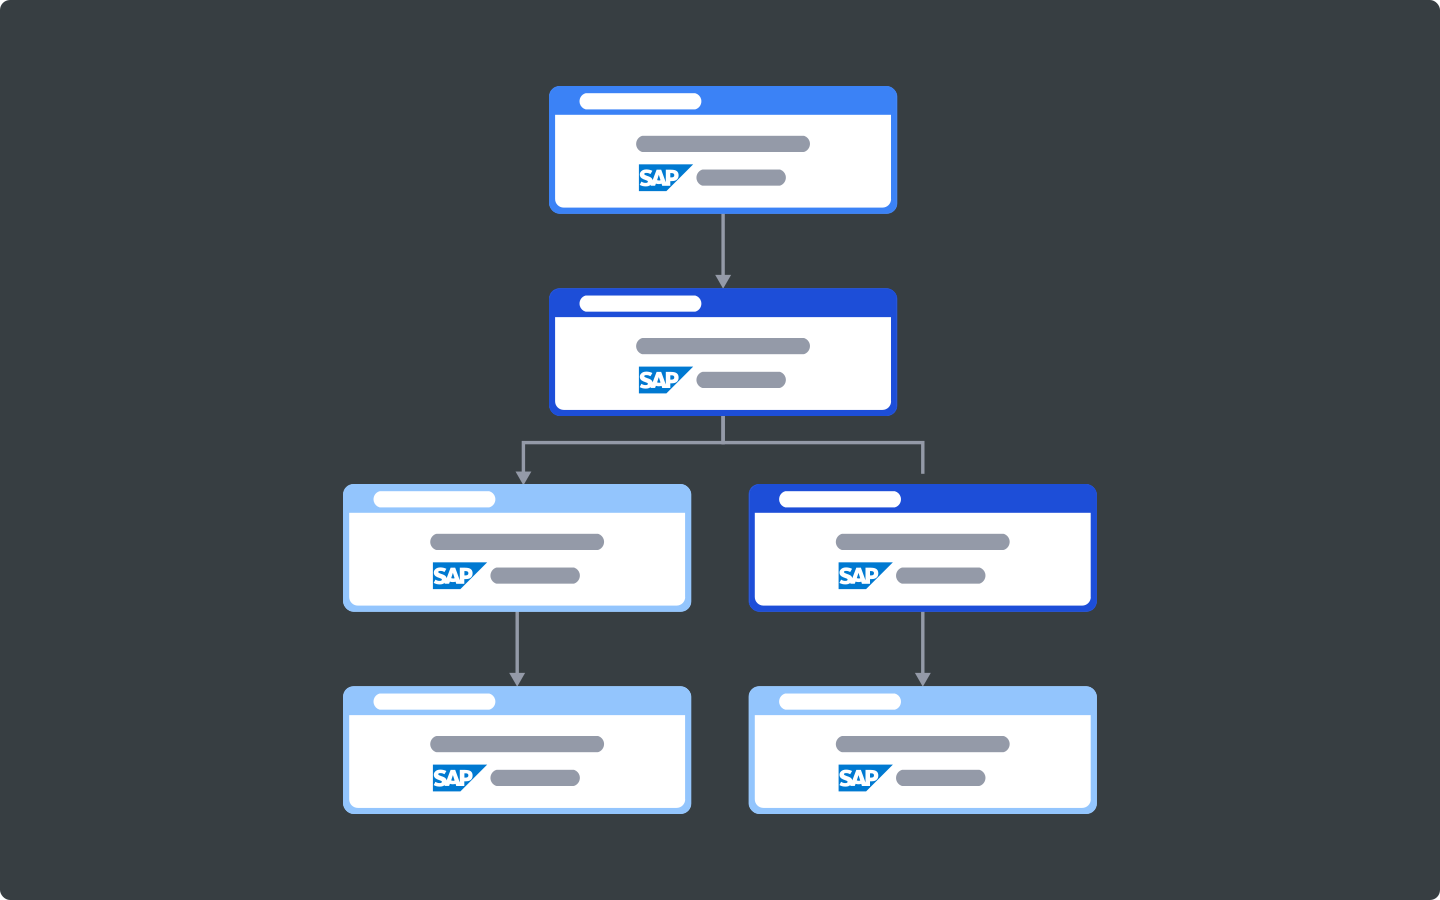
Vorher: Die SAP-Batch-Jobs eines Fertigungsunternehmens, etwa für Bestandsaktualisierungen, Auftragsverarbeitung und Finanzbuchungen, laufen nach festen Zeitplänen und unabhängig von den umliegenden Non-SAP-Systemen. Verzögert sich beispielsweise eine Aktualisierung im Warehouse-Management-System, erfahren nachgelagerte Teams davon häufig erst am nächsten Morgen, wenn ein Bericht fehlerhafte Daten enthält.
Nachher: Die Orchestrierung stimmt SAP-Jobschritte mit angrenzenden Prozessen wie Freigaben, Dateiübertragungen und dem nachgelagerten Reporting ab. Verzögert sich ein Prozessschritt, werden alle davon abhängigen Schritte zurückgehalten, anstatt fehlerhafte oder unvollständige Daten an nachgelagerte Systeme weiterzugeben.
Schon gewusst?
Die SAP-Orchestrierung von ANOW! Automate wurde kürzlich im offiziellen SAP Store gelistet. Das unterstreicht die wachsende Nachfrage nach Orchestrierungslösungen, die SAP- und Non-SAP-Workloads als einen zusammenhängenden Prozess koordinieren, anstatt sie getrennt voneinander zu behandeln.
Orchestrierung von Datenpipelines für Analytics und Machine Learning
Vorher: Ein Data-Team überträgt Daten aus operativen Systemen in ein Data Warehouse und stellt sie anschließend für BI-Dashboards und ML-Modelle bereit. Häufig geschieht dies über eine Kette aus Skripten und Cron-Jobs, verteilt auf Tools wie Snowflake, Databricks und dbt. Schlägt eine Datenextraktion unbemerkt fehl, wird unter Umständen keine Fehlermeldung ausgelöst. Das Ergebnis kann ein veraltetes Dashboard sein, dessen fehlerhafte Daten erst Tage später auffallen.
Nachher: Die Orchestrierung koordiniert Datenaufnahme, Transformation und Laden durchgängig über die gesamte Pipeline. Eine Anomalieerkennung identifiziert fehlende oder fehlerhafte Datensätze, bevor sie produktive Modelle oder Management-Dashboards erreichen. Der entscheidende Unterschied zum einfachen Scheduling für die Automatisierung von Datenpipelines liegt damit im Wechsel von „Der Job wurde ausgeführt“ zu „Der Job wurde ausgeführt und die Ergebnisse sind verlässlich“.
Jobs-as-Code-Orchestrierung für DevOps und CI/CD
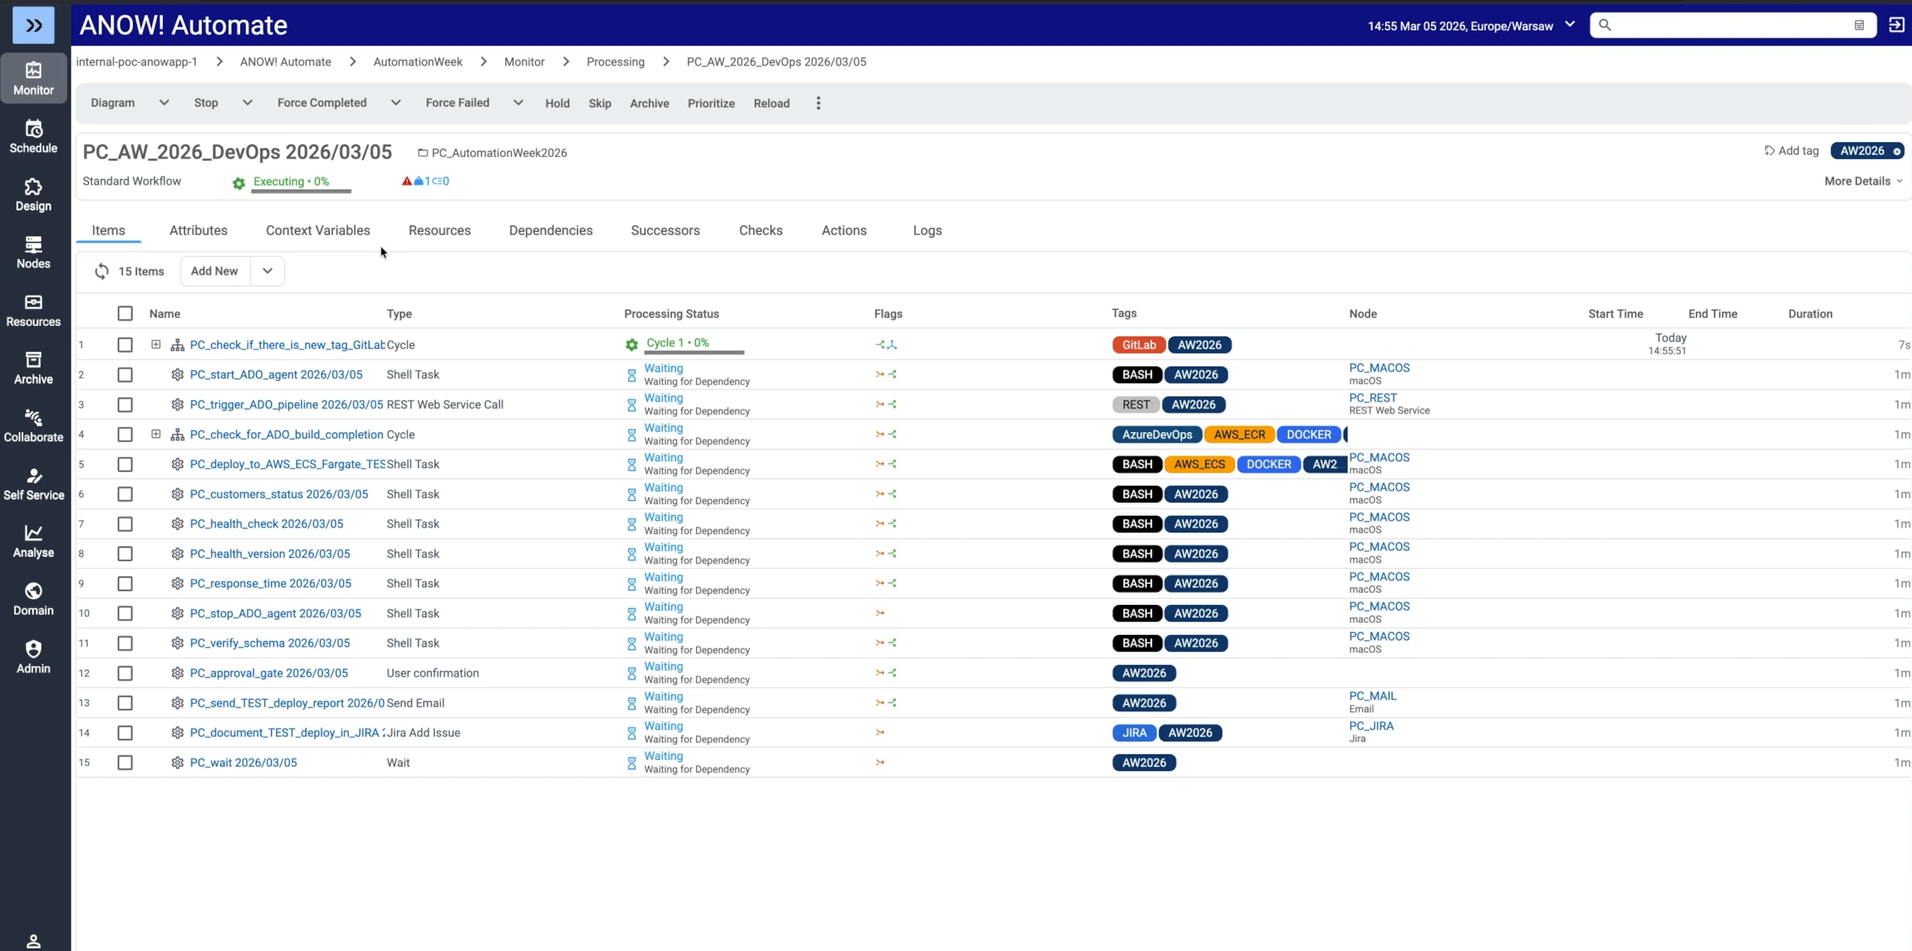
Vorher: DevOps-Teams verwalten Build-, Test- und Deployment-Schritte über eine Vielzahl unterschiedlicher Pipeline-Skripte, die jeweils von verschiedenen Teams verantwortet werden. Eine zentrale Sicht darauf, wie sich eine Änderung in einem Repository auf nachgelagerte Deployments auswirkt, fehlt.
Nachher: Mit einem Jobs-as-Code-Ansatz werden Automatisierungsartefakte als versionierte Definitionen verwaltet, die mit Git-basierten Systemen wie GitHub, GitLab und Bitbucket kompatibel sind. Branching, Tagging und Diffing funktionieren dadurch für Infrastruktur-Jobs genauso wie für Anwendungscode. DevOps- und Infrastrukturteams erhalten so eine gemeinsame, auditierbare Definition dafür, wie Jobs die Pipeline durchlaufen, anstatt auf implizites Wissen angewiesen zu sein, das über zahlreiche Skripte und Teams verteilt ist.
Workflow-Orchestrierung implementieren, ohne die bestehende IT-Landschaft zu beeinträchtigen
Orchestrierung auf einmal über die gesamte IT-Landschaft auszurollen, ist häufig der Grund dafür, dass Projekte ins Stocken geraten. Ein schrittweises Vorgehen reduziert Risiken und schafft intern Vertrauen in die neue Lösung.
Schritt 1: Zuerst die Workflows mit dem höchsten Risiko erfassen
Beginnen Sie mit systemübergreifenden Prozessen, die besonders strengen SLAs unterliegen oder besonders geschäftskritisch sind, beispielsweise Finanzabschlüsse, regulatorisches Reporting oder die Auftragsabwicklung. Entscheidend ist nicht, welche Prozesse sich am einfachsten automatisieren lassen.
Bei diesen Workflows können übersehene Abhängigkeiten besonders große Auswirkungen haben. Gleichzeitig lässt sich hier der Mehrwert der Orchestrierung frühzeitig besonders deutlich nachweisen und eine Grundlage dafür schaffen, anschließend weitere Prozesse einzubeziehen.
Schritt 2: Schrittweise migrieren statt mit einem einzigen Cutover
Einen Legacy-Scheduler in einem einzigen Schritt zu ersetzen, ist kaum realistisch, sobald Hunderte voneinander abhängige Jobs beteiligt sind.
Eine Migration nach Geschäftsbereich, System oder Workflow-Gruppe ermöglicht es Teams, jede Phase zu validieren, bevor sie mit der nächsten beginnen. Automatisierte Migrationstools, die bestehende Jobdefinitionen einlesen und übertragen, unterstützen diesen Ansatz. So werden fehlerhafte Abhängigkeiten nicht erst im Produktivbetrieb sichtbar.
Schritt 3: Observability von Anfang an einplanen
Transparenz sollte nicht erst nach dem ersten Ausfall zum Thema werden.
Wer SLA-Tracking, Logging und Monitoring auf Workflow-Ebene bereits bei der Konzeption berücksichtigt, anstatt später separate Dashboards für einzelne Systeme hinzuzufügen, kann Probleme erkennen, solange noch genügend Zeit zum Eingreifen bleibt.
Die wichtigsten Tools und Plattformen für Workflow-Orchestrierung
Welche Plattform am besten geeignet ist, hängt stark davon ab, wer sie einsetzt und welche Systeme und Prozesse damit koordiniert werden sollen.
So unterscheiden sich drei der am häufigsten evaluierten Optionen.
Beta Systems (ANOW! Automate)
 ANOW! Automate ist eine Cloud-native Plattform für Workload Automation und Orchestrierung, die speziell für den Einsatz im Enterprise-IT-Betrieb entwickelt wurde und sich nicht ausschließlich an Engineering-Teams richtet. Mit mehr als 500 nativen Integrationen für Cloud-Services, Container, Datenbanken, ERP-Systeme und Legacy-Scheduler bietet die Plattform eine der umfangreichsten sofort verfügbaren Connector-Bibliotheken unter den Anbietern von Enterprise Workload Automation.
Die OpenTelemetry-native Observability-Schicht ANOW! Observe bietet Teams eine zentrale Echtzeitansicht auf den Zustand ihrer Workflows über Hybrid-, Mainframe- und Cloud-Umgebungen hinweg. Gleichzeitig sorgt die Jobs-as-Code-Architektur dafür, dass Automatisierungsartefakte versioniert und Git-kompatibel verwaltet werden können, was insbesondere DevOps-Teams eine nahtlose Integration in bestehende Entwicklungsprozesse ermöglicht.
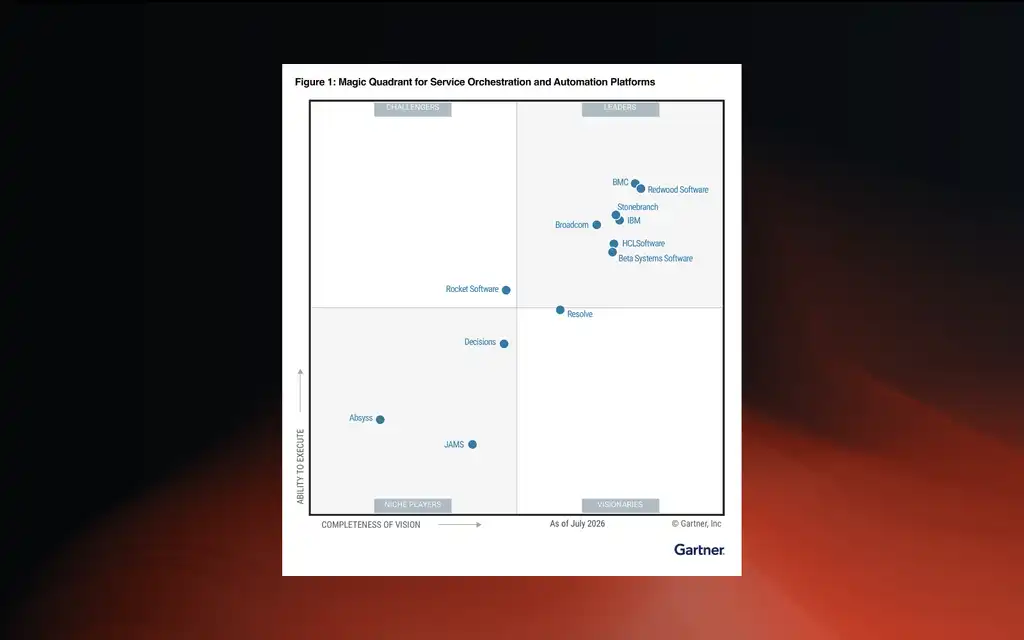
Beta Systems Software als Leader im Gartner® Magic Quadrant™ 2026 ausgezeichnet
Erfahren Sie, warum Analysten auf Beta Systems vertrauen, wenn es um Workload-Automatisierung und Observability auf Enterprise-Niveau im großen Maßstab geht.
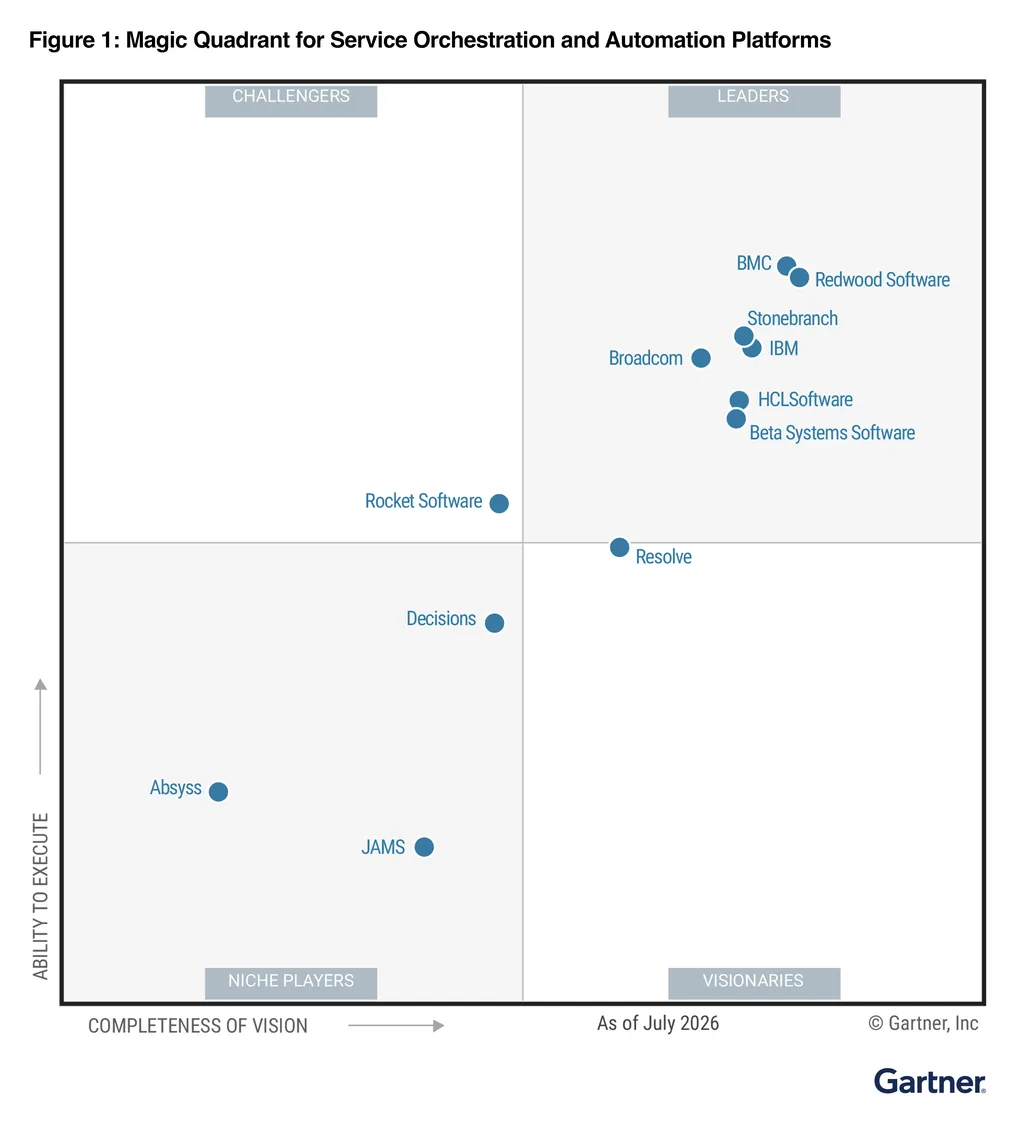
Für Unternehmen, die einen Legacy-Scheduler ablösen oder mehrere Einzellösungen konsolidieren möchten, vereint ANOW! Automate Workload Automation, Orchestrierung und Observability auf einer zentralen Plattform. Dabei profitieren Unternehmen von der Vermeidung eines Vendor Lock-ins und vollständiger Datensouveränität, insbesondere wenn sie europäische Compliance-Anforderungen erfüllen müssen.
Apache Airflow
Apache Airflow gehört zu den bekanntesten Lösungen im Bereich Workflow-Orchestrierung. Das weit verbreitete, von der Community gepflegte Framework wurde von und für Data-Engineering-Teams entwickelt, die mit der Definition von DAGs in Python vertraut sind. Seine Stärken liegen vor allem im Scheduling und Monitoring von Datenpipelines, wenn im Team bereits fundierte Python-Kenntnisse vorhanden sind und die Workflows überwiegend in Cloud-nativen, von Engineering-Teams betriebenen Systemen laufen.
Bei umfangreichen Enterprise-IT-Prozessen stößt Airflow jedoch an Grenzen. Aufbau und Betrieb erfordern umfassendes internes Python-Know-how, ein integriertes Enterprise-Supportmodell fehlt und für die plattformübergreifende Orchestrierung von Mainframes, SAP-Systemen oder Legacy-Schedulern bietet Airflow nur begrenzte native Funktionen.
Für Unternehmen, deren selbstverwaltete Airflow-Umgebung den steigenden Anforderungen nicht mehr gerecht wird und die eine umfassendere Orchestrierung geschäftskritischer Prozesse benötigen, zeigt unser Leitfaden zum Ersatz von Apache Airflow, worauf bei der Auswahl einer Alternative zu achten ist.
ServiceNow
ServiceNow betrachtet Orchestrierung primär aus der Perspektive des IT Service Managements und weniger aus Sicht der Workload Automation. Der Flow Designer und die modulübergreifenden Workflows eignen sich besonders für die Koordination von Tickets, Freigabeprozessen und Abläufen über ITSM, HR Service Delivery und Customer Service hinweg. Grundlage dafür ist ein gemeinsames Datenmodell.
Dieser ITSM-zentrierte Ansatz ist für IT-Operations-Teams zugleich eine Einschränkung: ServiceNow wurde nicht für die ereignisgesteuerte und abhängigkeitsbasierte Orchestrierung von Batch-Jobs, Datenpipelines oder Hybrid-Cloud-Workloads entwickelt, wie sie in Enterprise-IT-Umgebungen erforderlich ist.
Viele Unternehmen setzen ServiceNow daher für Service-Management-Workflows ein und nutzen parallel dazu eine dedizierte Workload-Automation-Plattform für die darunterliegende technische Ausführung, anstatt eine der beiden Lösungen vollständig durch die andere zu ersetzen.
Von fragmentierten Workflows zu skalierbaren, orchestrierten Prozessen
Task-Automatisierung ohne Orchestrierung verlagert das Koordinationsproblem lediglich auf die Person, die nachts um zwei Uhr Bereitschaftsdienst hat. Um diese Lücke zu schließen, müssen automatisierte Tasks als zusammenhängender Prozess betrachtet werden und nicht als Sammlung voneinander unabhängiger Skripte und Scheduler.
Wenn Ihr Team prüft, wie sich fragmentierte Automatisierungsprozesse in einer zentralen Orchestrierungsschicht zusammenführen lassen, bietet unser Leitfaden zur Workload Automation einen guten Einstieg. Alternativ können Sie sich direkt ansehen, wie ANOW! Automate die Orchestrierung über Hybrid-, Cloud- und Mainframe-Umgebungen hinweg ermöglicht.
FAQs
1. Was ist der Unterschied zwischen einem Workflow und einem Orchestrator?
Ein Workflow beschreibt die Abfolge von Tasks und Abhängigkeiten, aus denen sich ein Prozess zusammensetzt, beispielsweise „Datei validieren, laden und anschließend einen Report auslösen“. Ein Orchestrator ist die Plattform, die diese Abfolge ausführt und verwaltet. Er startet die einzelnen Schritte, löst Abhängigkeiten auf und übernimmt die Fehlerbehandlung. Der Workflow definiert also das „Was“, der Orchestrator steuert, „wie es ausgeführt wird“.
2. Brauche ich Workflow-Orchestrierung, wenn meine einzelnen Jobs bereits automatisiert sind?
Nicht unbedingt. Wenn automatisierte Jobs unabhängig voneinander laufen, keine systemübergreifenden Abhängigkeiten bestehen und keine SLA-Risiken entstehen, ist eine zusätzliche Orchestrierung möglicherweise noch nicht erforderlich. Relevant wird sie spätestens dann, wenn ein Fehler oder eine Verzögerung in einem Job unbemerkt einen nachgelagerten Prozess beeinträchtigen kann.
3. Welche Arten der Orchestrierung gibt es?
Enterprise-Orchestrierung lässt sich grundsätzlich in mehrere Bereiche unterteilen, die sich teilweise überschneiden:
Workload-Orchestrierung: Koordination von Batch-Jobs und zeitgesteuerten Prozessen
Datenorchestrierung: Koordination von Datenpipelines über Datenaufnahme, Transformation und Laden hinweg
Cloud-Orchestrierung: Bereitstellung und Koordination von Ressourcen über einen oder mehrere Cloud-Anbieter hinweg
Container-Orchestrierung: Verwaltung containerisierter Workloads über Plattformen wie Kubernetes
Service-Orchestrierung: Koordination von APIs und Microservices zur Ausführung eines Geschäftsprozesses
Die meisten Enterprise-IT-Umgebungen benötigen mehrere dieser Orchestrierungsarten gleichzeitig. Deshalb führen moderne Plattformen diese Funktionen zunehmend in einer gemeinsamen Orchestrierungsschicht zusammen.
4. Welche Workflow-Orchestrierungs-Tools eignen sich für welchen Einsatzbereich?
Das hängt vor allem davon ab, wer die Workflows betreibt und welche Prozesse orchestriert werden sollen. Community-basierte Frameworks wie Apache Airflow eignen sich für Engineering-Teams, die Datenpipelines in Python entwickeln und verwalten. ITSM-Plattformen wie ServiceNow sind auf genehmigungsbasierte Geschäftsprozesse ausgerichtet.
Enterprise-Plattformen wie ANOW! Automate von Beta Systems richten sich an IT-Operations-Teams, die Mainframe-, Cloud-, SAP- und Daten-Workloads gemeinsam auf einer Plattform orchestrieren und dabei Enterprise-Support benötigen.
5. Müssen bestehende Automatisierungstools für Workflow-Orchestrierung ersetzt werden?
Nicht unbedingt. Die meisten Enterprise-Orchestrierungsplattformen lassen sich oberhalb oder parallel zu bestehenden Schedulern und Skripten einsetzen und koordinieren diese. Ein sofortiger vollständiger Austausch der bestehenden Automatisierungslandschaft ist daher nicht zwingend erforderlich.
Möchten Sie mehr über ANOW! Automate erfahren?
Erfahren Sie, wie ANOW! Automate Unternehmen dabei unterstützt, ihre Workload Automation zu modernisieren, ohne geschäftskritische Workflows neu aufbauen zu müssen.